生成式 AI 快速崛起,改變了人們處理日常工作的方式。從撰寫電子郵件、規劃旅遊行程,到回答網購客服問題,輸入文字就能取得回覆。但 AI 也可能編造景點資訊、誤解退貨規則,或產生偏見內容,因此需要透過測試了解系統的品質與安全性。
ISO/IEC 42119-8 的目標是建立這類文字系統的評估方法,提升測試結果的可重複性與可比性。截至 2026 年 10 月 13 日,ISO 官方列為開發中的 ISO/IEC AWI TS 42119-8 技術規範工作項目,尚未發布。
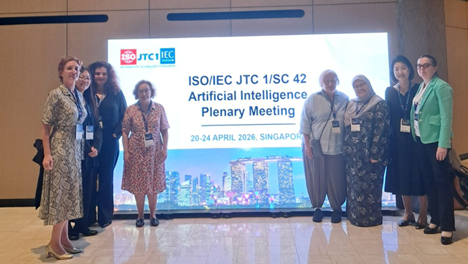
這項提案聚焦「運用生成式 AI 的提示型文字對文字系統品質評估」,例如以文字提示產生回覆的聊天機器人或企業問答應用。新加坡資訊傳媒發展局(IMDA)與新加坡企業發展局(EnterpriseSG)於 2026 年 4 月公開推動此案,並說明將於第 17 次 ISO/IEC JTC 1/SC 42 全體會議討論。
評測重點包括基準測試(benchmarking)與紅隊測試(red teaming)。前者以設定好的資料集與評分方式檢視系統表現;後者透過對抗性提示等方式找出弱點。依公開資訊,提案亦涵蓋結果分析、解讀及文件紀錄,並銜接 ISO/IEC 42119-7 等既有標準工作。幻覺、偏見與不當內容可作為實務評估議題,具體要求仍應以後續正式文件為準。
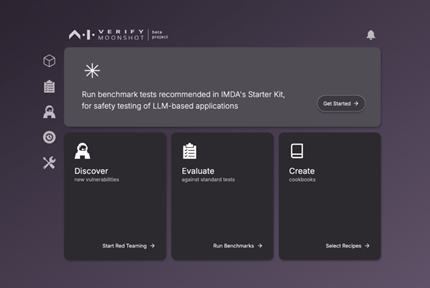
實務工具方面,AI Verify Foundation 的開源 Project Moonshot 提供基準測試與紅隊測試功能,可作為建立評測流程的參考。AIEC 既有 Moonshot 比較簡報也提醒,題型與資料集設定會影響結果解讀;使用工具不代表已符合 ISO/IEC 42119-8。
企業可先依應用情境設定評測目標,準備符合使用語言的測試資料,記錄模型版本、提示詞與評分方式,並在系統更新後重新測試。這些準備有助於追蹤品質變化,也讓後續採購與風險管理具備可查核的依據。